Что такое llama-swap?
llama-swap — это прокси/роутер для локальных GenAI‑серверов, который умеет переключать запущенный сервер под нужную модель по полю model в запросе к OpenAI‑совместимому API. Это удобно, когда на одной ВМ нужно обслуживать несколько моделей и запускать их по требованию.
1. Проверка видеокарт и версии CUDA через nvidia-smi
На ВМ выполните:
nvidia-smiВ выводе проверьте:
- список GPU (их имена и количество);
- строку
CUDA Version— запомните её (ниже пригодится при выборе Docker‑образа).
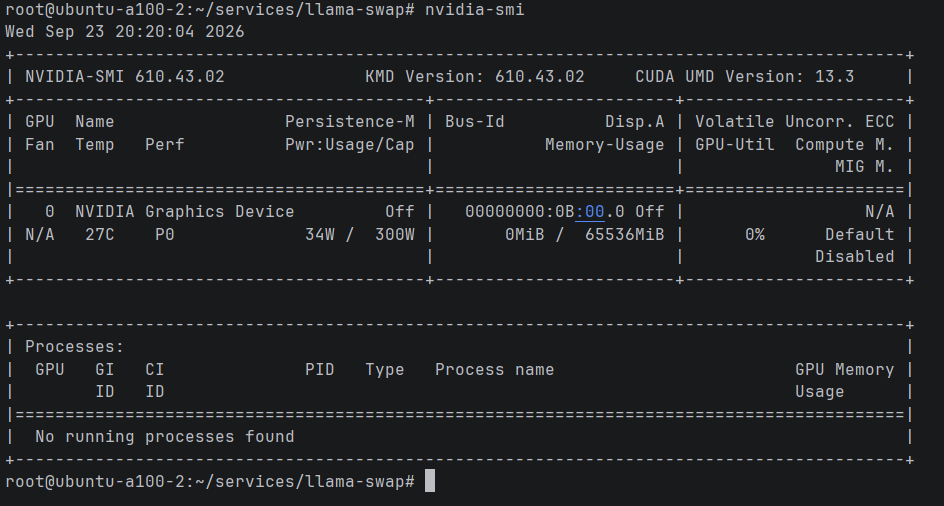
Примечание: CUDA Version в nvidia-smi — это версия CUDA, поддерживаемая установленным драйвером (это хороший ориентир, какой CUDA‑образ выбирать).
2. Установка Docker на Ubuntu
Ниже — команды из официальной инструкции установки Docker Engine через apt.
2.1 Удаление конфликтующих (старых) пакетов
sudo apt remove $(dpkg --get-selections docker.io docker-compose docker-compose-v2 docker-doc docker-buildx podman-docker containerd runc | cut -f1)2.2 Добавление репозитория Docker в apt
sudo apt update
sudo apt install ca-certificates curl
sudo install -m 0755 -d /etc/apt/keyrings
sudo curl -fsSL https://download.docker.com/linux/ubuntu/gpg -o /etc/apt/keyrings/docker.asc
sudo chmod a+r /etc/apt/keyrings/docker.asc

sudo tee /etc/apt/sources.list.d/docker.sources <<EOF
Types: deb
URIs: https://download.docker.com/linux/ubuntu
Suites: $(. /etc/os-release && echo "${UBUNTU_CODENAME:-$VERSION_CODENAME}")
Components: stable
Architectures: $(dpkg --print-architecture)
Signed-By: /etc/apt/keyrings/docker.asc
EOF

sudo apt update
2.3 Установка Docker Engine и Docker Compose Plugin
sudo apt install docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin
3) Установка nvidia-container-toolkit + настройка Docker под NVIDIA
Ниже — команды из официального install‑guide (вариант apt для Ubuntu/Debian) и шаг конфигурации Docker.
3.1 Установка зависимостей
sudo apt-get update && sudo apt-get install -y --no-install-recommends \
   ca-certificates \
   curl \
   gnupg2
3.2 Подключение apt-репозитория NVIDIA Container Toolkit
curl -fsSL https://nvidia.github.io/libnvidia-container/gpgkey | sudo gpg --dearmor -o /usr/share/keyrings/nvidia-container-toolkit-keyring.gpg \
  && curl -s -L https://nvidia.github.io/libnvidia-container/stable/deb/nvidia-container-toolkit.list | \
    sed 's#deb https://#deb [signed-by=/usr/share/keyrings/nvidia-container-toolkit-keyring.gpg] https://#g' | \
    sudo tee /etc/apt/sources.list.d/nvidia-container-toolkit.list

sudo apt-get update
3.3 Установка пакетов nvidia-container-toolkit
В документации пример дан с фиксацией версии через переменную NVIDIA_CONTAINER_TOOLKIT_VERSION:
export NVIDIA_CONTAINER_TOOLKIT_VERSION=1.20.1-1
sudo apt-get install -y \
    nvidia-container-toolkit=${NVIDIA_CONTAINER_TOOLKIT_VERSION} \
    nvidia-container-toolkit-base=${NVIDIA_CONTAINER_TOOLKIT_VERSION} \
    libnvidia-container-tools=${NVIDIA_CONTAINER_TOOLKIT_VERSION} \
    libnvidia-container1=${NVIDIA_CONTAINER_TOOLKIT_VERSION}
3.4 Конфигурация Docker для работы с NVIDIA runtime
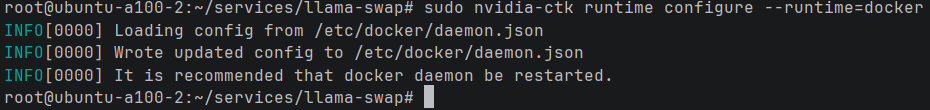
sudo nvidia-ctk runtime configure --runtime=docker
sudo systemctl restart docker
Успешное выполнение nvidia-ctk runtime configure --runtime=docker:
4. Создание каталогов и файлов для llama-swap
Создаём структуру:
mkdir -p ~/services/llama-swap
mkdir -p ~/services/llama-swap/models
cd ~/services/llama-swap

touch docker-compose.yml
touch config.yaml
4.1 docker-compose.yml для llama-swap
Важно: у llama-swap есть разные CUDA‑варианты образов:
unified-cuda— сборка под CUDA 12,unified-cuda13— сборка под CUDA 13.
Ориентируйтесь на CUDA Version из nvidia-smi:
- если 12.x → берите
unified-cuda - если 13.x → берите
unified-cuda13
Пример docker-compose.yml:
services:
  llama-swap:
    # CUDA 12:
    # image: ghcr.io/mostlygeek/llama-swap:cuda
    # CUDA 13:
    image: ghcr.io/mostlygeek/llama-swap:cuda13

    ports:
      - "3000:8080"

    environment:
      # Переменные для NVIDIA Container Runtime
      - NVIDIA_VISIBLE_DEVICES=all
      - NVIDIA_DRIVER_CAPABILITIES=all
      - NVIDIA_DISABLE_REQUIRE=true
    volumes:
      - ./models:/models
      - ./config.yaml:/app/config.yaml
    restart: unless-stopped
5. Скачивание модели с Hugging Face (формат GGUF)
Под капотом вы будете запускать llama-server (проект llama.cpp), который принимает модели формата .gguf.
В примере используем Unsloth Qwen3.8‑27B GGUF, файл квантования UD‑Q4_K_XL (он крупный — ~17.6 GB).
5.1 Загрузка модели в каталог models
Перейдите в каталог моделей и скачайте файл:
cd ~/services/llama-swap/models

wget https://huggingface.co/unsloth/Qwen3.8-27B-GGUF/resolve/main/Qwen3.8-27B-UD-Q4_K_XL.gguf
Проверьте, что файл появился:
ls -lh ~/services/llama-swap/models
6. Заполнение конфигурации и тестовый запуск
6.1 Пример config.yaml + пояснение параметров
Вставьте в ~/services/llama-swap/config.yaml:
models:
  main:
    ttl: 10800
    aliases:
      - qwen3.8-27b-ud-q4
    cmd: |
      llama-server
      --host 127.0.0.1
      --port ${PORT}

      --model /models/Qwen3.8-27B-UD-Q4_K_XL.gguf
      --alias qwen3.8-27b-ud-q4

      --flash-attn on
      --load-mode none
      --cont-batching
      --webui-mcp-proxy

      --n-gpu-layers 99
      --ctx-size 262144

      --temp 0.7
      --top-p 0.8
      --top-k 20
      --min-p 0.0
      --presence-penalty 1.5

      --cache-type-k q8_0
      --cache-type-v q8_0

      --reasoning off
Что означают параметры llama-swap (верхняя часть)
models:— список моделей, которыми будет управлять llama-swap.main:— внутренний ID модели (может быть любым удобным именем).ttl: 10800— время жизни (в секундах), после которого неиспользуемый upstream можно выгрузить/остановить (экономия VRAM/RAM).aliases:— список алиасов (имен модели), которые клиент может передавать в OpenAI‑запросах какmodel. В нашем примере клиент указываетqwen3.8-27b-ud-q4, а llama-swap понимает, какой upstream запустить.cmd:— команда запуска upstream‑сервера. llama-swap подставляет${PORT}и запускает процесс, затем проксирует к нему OpenAI‑совместимые запросы. Механика «swap» описана в документации проекта: llama-swap смотритmodelв запросе и при необходимости заменяет запущенный upstream на нужный.
Что означают ключевые параметры llama-server (внутри cmd)
Сетевые параметры:
--host 127.0.0.1— upstream слушает только loopback внутри окружения (безопаснее: снаружи виден только llama-swap).--port ${PORT}— порт задаёт llama-swap (вам не нужно фиксировать его вручную).
Модель:
--model /models/...gguf— путь к GGUF‑файлу (мы примонтировали./modelsкак/models).--alias ...— алиас модели на сторонеllama-server(удобно для отображения/маршрутизации).
Производительность/память:
--n-gpu-layers 99— сколько слоёв модели держать в VRAM (ускоряет генерацию). В актуальных сборках допустимы числа, а также значенияauto/all.
Практика: если не уверены — используйтеallили уменьшайте число при нехватке VRAM.--ctx-size 262144— размер контекста (в токенах). Большой контекст требует заметно больше памяти под KV‑кэш; при ошибках OOM уменьшайте это значение.--cache-type-k q8_0и--cache-type-v q8_0— тип квантования KV‑кэша (уменьшает потребление памяти ценой некоторого влияния на качество/скорость). Список допустимых типов описан в документации llama-server.--flash-attn on— принудительное включение Flash Attention (технология оптимизации GPU-вычислений, часто помогает производительности; также в документации llama.cpp отмечается как важный флаг в ряде режимов и конфигураций).--cont-batching— continuous/dynamic batching (лучше утилизация GPU при нескольких запросах).
Загрузка модели:
--load-mode none— режим загрузки «без mmap» (для единовременной загрузки модели в VRAM)
Если ваша сборкаllama-serverне понимает--load-mode, замените на--no-mmap(опция описана в llama-server).
Сэмплинг (управляет «креативностью»):
--temp,--top-p,--top-k,--min-p,--presence-penalty— параметры сэмплинга и штрафов, влияющие на разнообразие ответа. Описание--top-k/--top-p/--min-p/--presence-penaltyесть в llama-server.
Reasoning/Thinking:
--reasoning off— отключает «reasoning/thinking» режим (если сборка/модель его поддерживает).
Документация llama-server: https://github.com/ggml-org/llama.cpp/tree/master/tools/server
6.2 Запуск llama-swap
Из каталога ~/services/llama-swap выполните:
docker compose up -dПроверка статуса:
docker compose psЕсли статус Up — сервис запущен.

Локально на ВМ интерфейс будет доступен по адресу:
http://localhost:3000Доступ из браузера снаружи (через DNAT в VMware Cloud Director)
Чтобы открыть доступ извне, добавьте DNAT‑правило на Edge (VMware Cloud Director):
- Откройте Edge виртуального датацентра, где создана ВМ.
- Перейдите в раздел NAT.
- Добавьте DNAT‑правило:
- External IP: внешний IP
- External Port: внешний порт (например, 3000 или любой другой)
- Protocol: TCP
- Internal IP: внутренний IP ВМ
- Internal Port:
3000 - при необходимости задайте Source IP/Source Port (ограничение доступа)
После этого интерфейс откроется по:
http://{внешний_IP}:{внешний_порт}